随着存算一体写入国家“十五五”规划,国产算力产业正迎来加速发展的关键窗口期。政策信号明确,产业方向清晰,但窗口期从来只对有准备的技术方案敞开。亿铸科技全数字存算一体,正以经第三方验证的能效比优势、3D DRAM技术突破和已流片的工程化成果,把这一政策机遇转化为可部署的算力底座选择。  存储墙倒逼架构换道:政策为何此时出手? 传统冯·诺依曼架构下,存储与计算分离的基本逻辑已运行数十年。但随着大模型参数规模持续膨胀,数据在存储单元与计算单元之间频繁搬运所产生的能耗与延迟,成为制约有效算力释放的核心瓶颈。据亿铸科技在WAIC 2026期间披露的产业观察,数据传输与计算的耗时呈现约100:1的不平衡状态,大量时间消耗在数据传输通道上。 在此背景下,产业界围绕HBM升级、先进封装、高速互联所做的大量努力,本质上仍停留在“优化搬运”阶段,而非消除搬运本身。存算一体从计算架构层面减少数据搬运损耗,被视为重要的破局路径。“十五五”规划将存算一体列为新计算范式布局方向,正是对这一底层矛盾的制度性回应——政策并非追逐概念,而是为一条已被验证的技术路线提供规模化落地所需的制度推力。 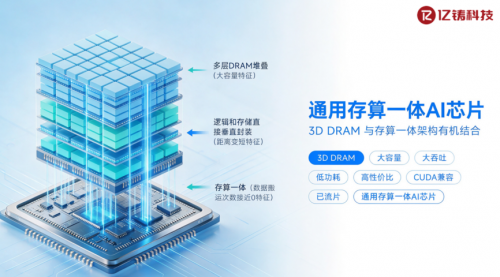 从POC到全链路验证:亿铸科技全数字存算一体的技术底牌 政策窗口打开,承接者需要拿出经得起检验的方案。亿铸科技全数字存算一体的技术底气,集中体现在三个层面。 其一,能效比优势经第三方验证。早在POC阶段,亿铸科技基于忆阻器的高精度、低功耗存算一体AI大算力芯片,能效比表现比传统架构AI芯片的平均水平高出10倍以上,并且是在传统工艺制程上实现的。这意味着国产芯片可以在不依赖最先进制程的前提下,通过架构创新实现能效比的跃升。 其二,3D DRAM技术路线取得工程化突破。基于3D DRAM的全数字通用存算一体AI芯片已成功流片,完成从理论到硬件的全链路验证。3D DRAM提供海量容量基础,存算一体消除架构性损耗,3D封装实现高带宽互联,三者融合被认为是当前应对AI数据搬运瓶颈的有效技术组合。 其三,全数字路线确保精度与通用性。相较于模拟存算一体在精度一致性上的天然局限,全数字方案在确保计算精度的同时,通过存算一体IP与通用计算模块的异构融合,使芯片既能承担矩阵计算加速,又具备独立完成完整AI计算任务的能力,而非仅作为协处理器存在。亿铸科技全数字存算一体方案满足架构通用、生态通用、计算通用三重属性,可复用现有CUDA与PyTorch生态,降低迁移成本。  面向大模型推理场景的算力经济账 技术的价值最终要在场景中兑现。经测试验证,对比主流云端GPU,亿铸通用存算方案可实现约2倍性能提升、约1/5功耗、约1/6成本的综合表现。在大模型推理场景下,同等业务规模的推理算力综合TCO最高可下降约88%。对于数据中心运营方和云计算服务商而言,这一TCO降幅意味着大模型推理的规模化部署不再被算力成本刚性约束。 亿铸科技全数字存算一体方案的产品矩阵覆盖从算力卡、工作站、一体机到推理集群的完整部署形态,核心服务于云端智算中心、运营商与互联网算力平台、行业私有云等场景。方案同时适配Agentic AI时代的新算力需求,支持1M超长上下文窗口、混合精度与MoE稀疏计算、集群级KV Cache池化等特性,可降低KV Cache检索延迟,提升长程任务处理能力。 “十五五”为存算一体打开的窗口期,本质上是国产算力从“制程追赶”转向“架构突围”的战略机遇。亿铸科技全数字存算一体以经第三方验证的10倍能效比、3D DRAM技术路线和已流片的工程化成果,将政策信号落到可部署的算力底座上,也为大模型推理时代的算力经济账提供了有据可依的国产方案。 郑重声明:此文内容为本网站转载企业宣传资讯,目的在于传播更多信息,与本站立场无关。仅供读者参考,并请自行核实相关内容。
|